文章目录
海外科技与出海商业前沿迭代极快。本文拆解一手事实真相、底层因果逻辑与商业连锁影响,供跨境操盘手与科技团队参考,避免被表面通稿遮蔽。
在全球科技与出海商业领域,最新披露的一起核心动态正在引发行业的剧烈震动。
根据权威行业媒体 電腦王阿達 的最新追踪报道,围绕《自架国产大模型省钱是骗局 四张顶级显卡每月成本竟比闭源模型贵两倍多》的底层事实正在对整个上下游生态产生深远的连带冲击。
很多团队在面对这类行业质变时,往往只习惯于看公关宣传口径里的宏大叙事,而忽略了技术演进背后的利益分配与真实商业账本。
任何一项新技术的落地或者商业规则的重塑,本质上都是对存量效率体系的降维洗牌。
一、 核心事实与现场事件由头
从一手现场还原来看,这次事件的爆发绝非偶然,而是行业发展到特定周期后的必然结果。
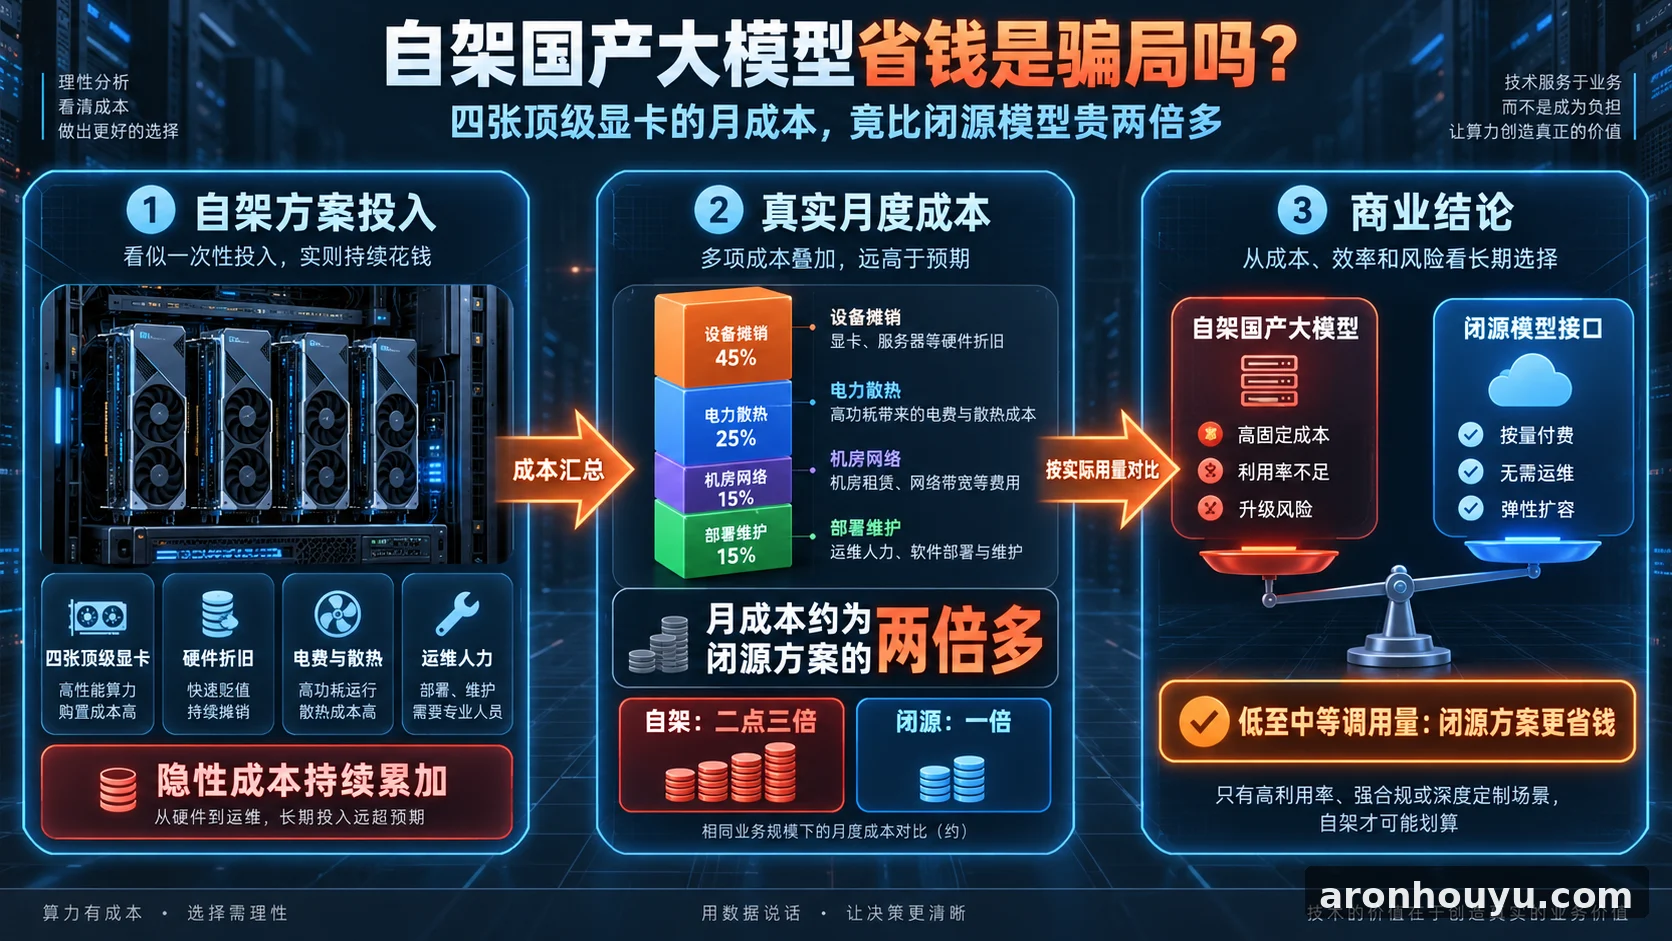
隨著免費開放權重模型越來越強,很多人開始覺得,與其長期訂閱 Claude、ChatGPT 等 AI 服務,不如直接改用本地 LLM,或自己租 GPU 來跑模型,整體應該會省不少。尤其 DeepSeek V4.1 Flash 推出後,國外就有不少開發者開始考慮租用 GPU 自架 DeepSeek,取代原本每天使用的 Claude Code。根據外媒報導,美國一間顧問公司就進行了這項實測。他們租下 4 張 NVIDIA H200,準備讓 DeepSeek V4.1 Flash 接手原本由 Claude Opus 5.5 負責的寫程式工作,但最終成本不是大家想的那樣省,而且由於安全問題,DeepSeek 最後甚至沒有投入程式碼撰寫。 The post 自架 DeepSeek 真的比較省?國外公司租 4 張 H200 實測,每月成本竟是 Claude 的兩倍多 appeared first on 電腦王阿達.
在实际推进过程中,相关核心团队针对传统模式的致命软肋进行了全方位的专项攻坚,力求在性能、转化率和成本结构上建立起难以逾越的壁垒。
但伴随着这种颠覆性方案的普及,旧有利益格局中的被替代者也开始显现出强烈的防御反应。
二、 为什么传统方案难以解决当前痛点
在过去很长一段时间里,行业普遍依赖上一代标准化解决方案来维系基本运转。
然而随着业务复杂度的几何级上升,传统方案的高昂隐性成本开始全面失控:
第一是系统链路的脆弱性,一旦某一单点发生故障,整条前后端履约流立刻瘫痪;
第二是维护成本极其沉重,企业为了修补旧系统的漏洞,不得不耗费大量人肉精力做低效打补丁;
第三是面对外部巨头的降维打击时,缺乏快速自我迭代和弹性扩容的底气。
这次新方案的突围,正是精准击中了这三大致命弱点,才得以在短时间内引发整个行业的跟风与震荡。
▲ 视频 1:围绕该事件的官方实操报道与深度解析(支持在网站内直接点击播放)
三、 给科技与出海团队的三点硬核落地建议
对于正在从事出海增长、硬件制造以及技术自动化的团队来说,这起动态给出了极其清晰的操盘航标:
第一点:坚决放弃对旧平台流量红利的依赖,尽快构建全渠道、具备强韧性的数据闭环;
第二点:深入技术与供应链底层,把每一个元器件、每一行代码的专利与合规底细摸清,不给海外法务留下把柄;
第三点:算准每一笔预算的真实商业产出,用后端真实到账的利润和留存率作为衡量一切创新的唯一试金石。